
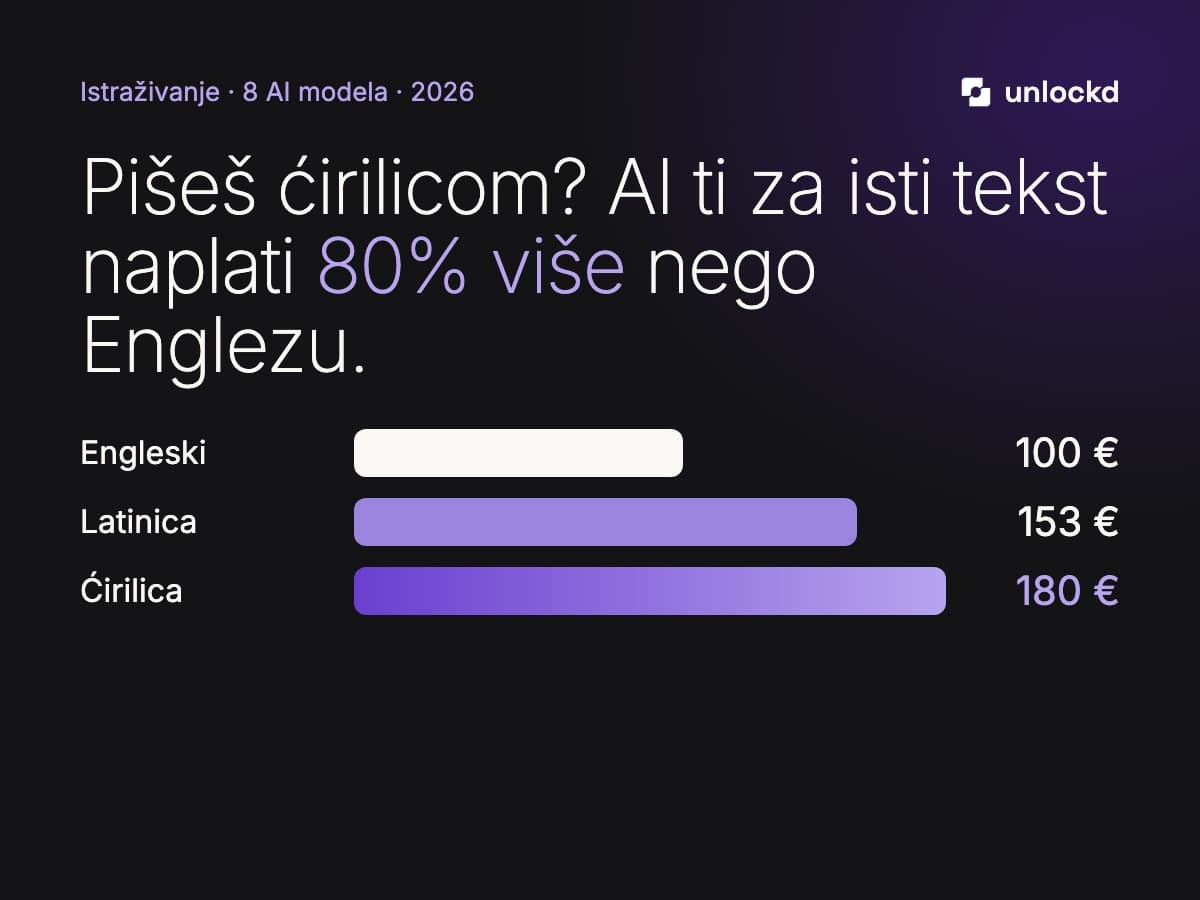
Isti tekst na srpskom AI modeli naplaćuju 50 do 84% više nego na engleskom, a na ćirilici još 5 do 24% više. Merili smo 8 najnovijih modela na vestima iz 2026.
Kada firma koristi GPT, Gemini ili bilo koji drugi jezički model preko API veze, ne plaća po reči, nego po tokenu. Token je komad teksta iz rečnika modela. Nekad je to cela reč, nekad samo slog ili jedno slovo. Što se tekst raspadne na više komada, to je račun veći, odgovor sporiji, a model odjednom može da drži manje teksta u memoriji.
Hteli smo da proverimo koliko komada ispadne iz srpskog teksta i da li je važno kojim pismom je napisan. Odgovor je da jeste: u svakom od osam modela koje smo merili, isti srpski tekst na ćirilici troši više tokena nego na latinici.
Kako smo merili
Uzeli smo 136 članaka sa sajta RTS objavljenih od aprila do oktobra 2026. godine, ukupno 2.157 pasusa. Tekstovi su napisani ćirilicom, a mi smo ih slovo po slovo preslovili u latinicu. Tako smo dobili dve verzije potpuno istog teksta, gde je jedina razlika pismo.
Za poređenje sa engleskim i drugim jezicima koristili smo Microsoftov skup profesionalnih prevoda NTREX-128, u kome istih 1.997 rečenica postoji na engleskom, srpskom, hrvatskom, bosanskom, slovenačkom, makedonskom, bugarskom, ruskom i ukrajinskom.
Sve tekstove smo propustili kroz tokenizere, delove modela koji tekst seku na tokene. Merili smo GPT-5 (OpenAI), Gemini (Google, preko otvorenog modela Gemma 4, za koji Google u izveštaju iz juna 2026. navodi da koristi isti tokenizer kao Gemini), Llama 4 (Meta), Mistral Medium 3.5, DeepSeek V4.1, Qwen3.8 (Alibaba), Kimi K3 (Moonshot) i GLM-5.3 (Z.ai).
Istraživanja objavljena ove godine pokazala su da tokenizeri skuplje naplaćuju slovenske jezike, a posebno ukrajinski. Merenje za srpsku latinicu i ćirilicu na najnovijim modelima i na srpskim tekstovima iz 2026. nismo pronašli, pa smo ga uradili sami.
Šta smo dobili
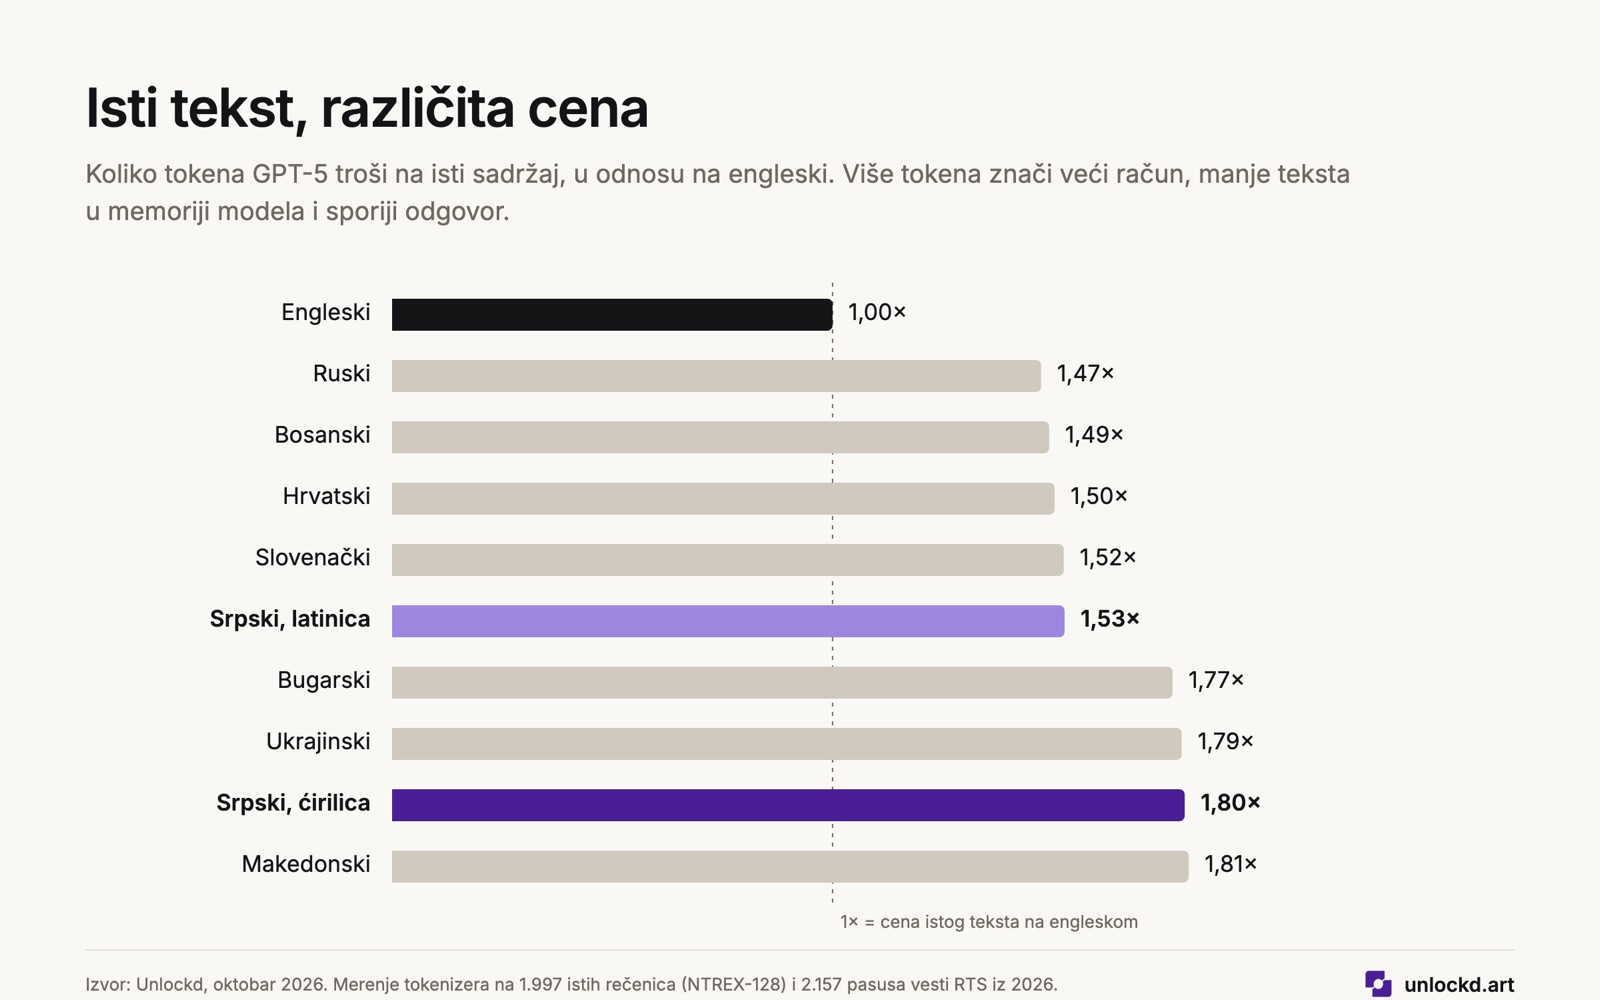
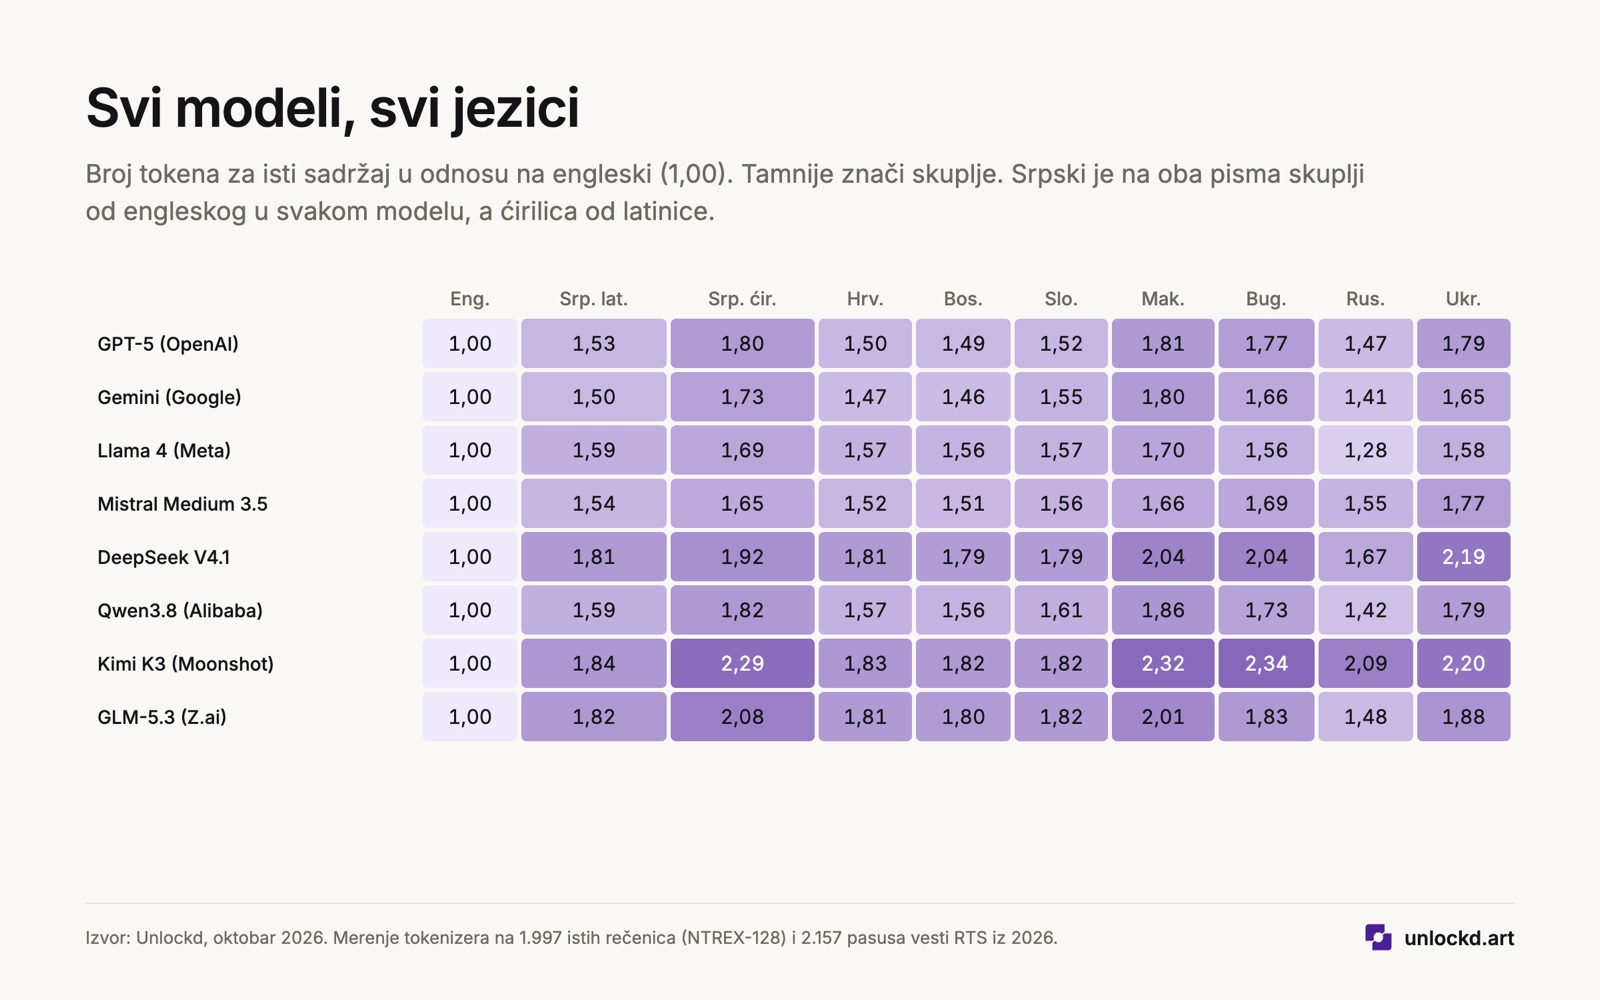
Srpski je skuplji od engleskog u svakom modelu. Na GPT-5 isti sadržaj na engleskom zauzme 100 tokena, na srpskoj latinici 153, a na srpskoj ćirilici 180. Kod svih osam modela latinica košta od 50 do 84 odsto više od engleskog, a ćirilica od 65 do 129 odsto više.
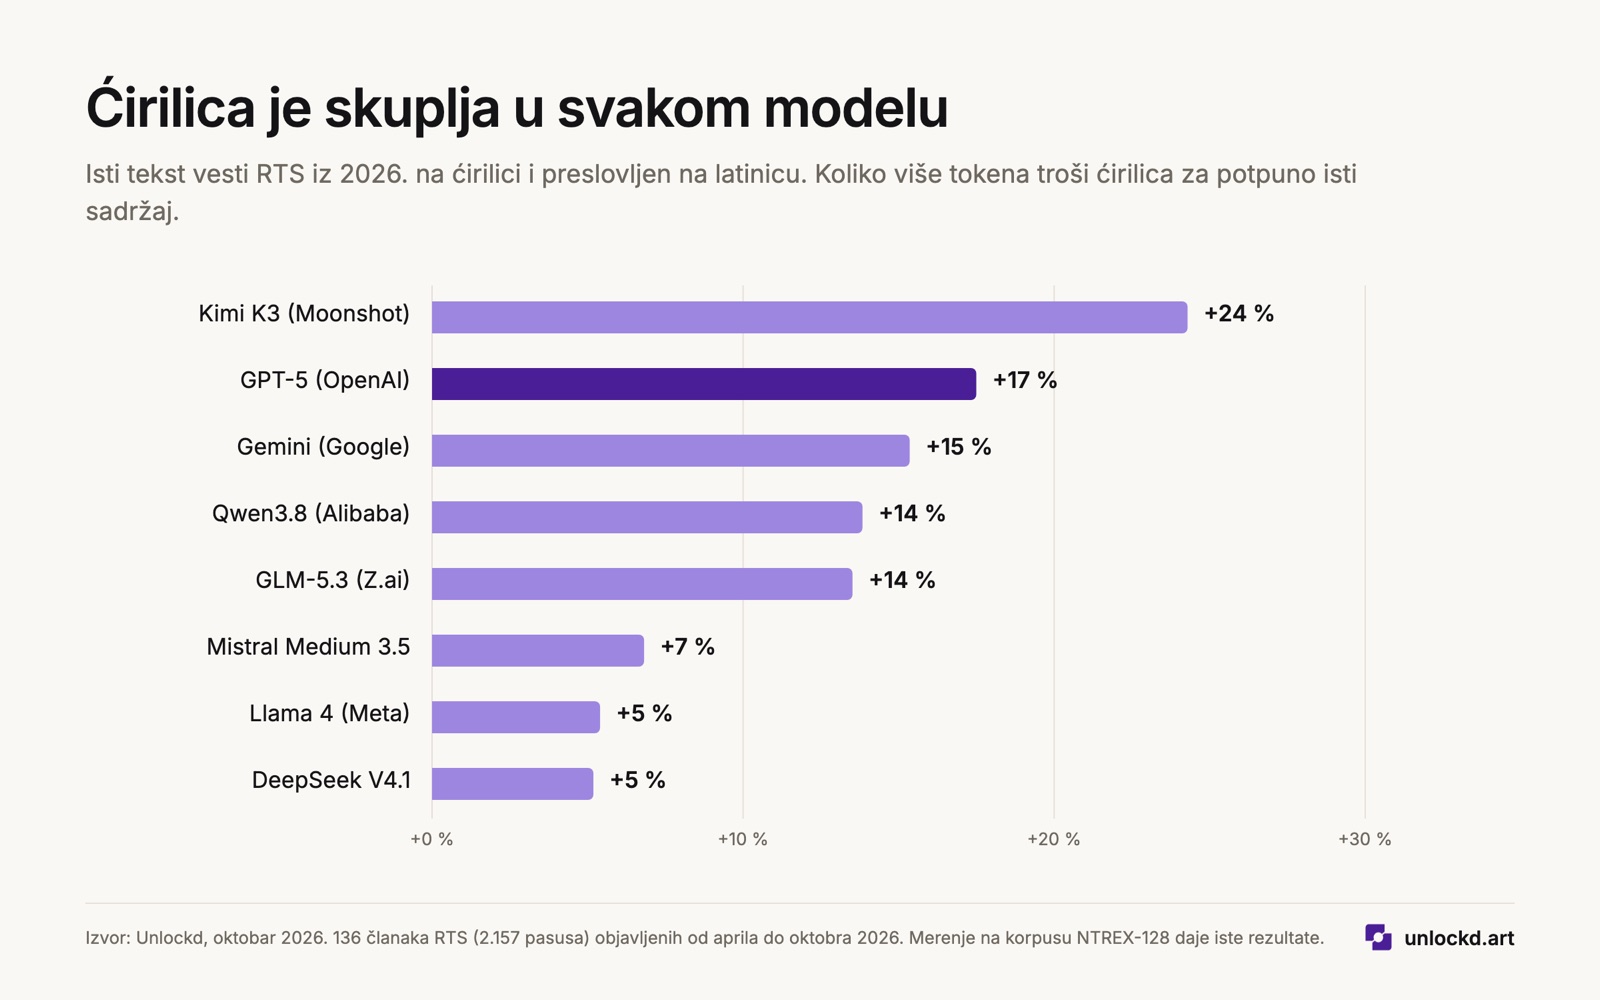
Ćirilica je skuplja od latinice u svih osam modela. Na vestima RTS razlika je najveća kod modela Kimi K3, 24 odsto, zatim kod GPT-5, 17 odsto, i kod Googleovog Gemini, 15 odsto. Qwen3.8 i GLM-5.3 ćirilicu naplaćuju 14 odsto više, Mistral 7, a Llama 4 i DeepSeek 5 odsto. Na GPT-5 je ćirilični pasus skuplji od latiničnog u 99 odsto slučajeva. Na Microsoftovom skupu prevoda dobili smo gotovo iste brojke, pa rezultat ne zavisi od izbora tekstova.
Ruski prolazi bolje od srpske ćirilice. Ruski, koji se takođe piše ćirilicom, troši manje tokena od srpske ćirilice u svih osam modela. Na GPT-5 ruski tekst troši 1,47 tokena na svaki token engleskog, što je manje i od srpske latinice. Problem, dakle, nije samo u pismu.
Zašto je tako
Tokenizer pravi svoj rečnik tako što na ogromnoj količini teksta traži delove reči koji se najčešće ponavljaju. Ono što se često pojavljuje dobija svoj token, a ono što je retko ostaje razbijeno na sitne delove.
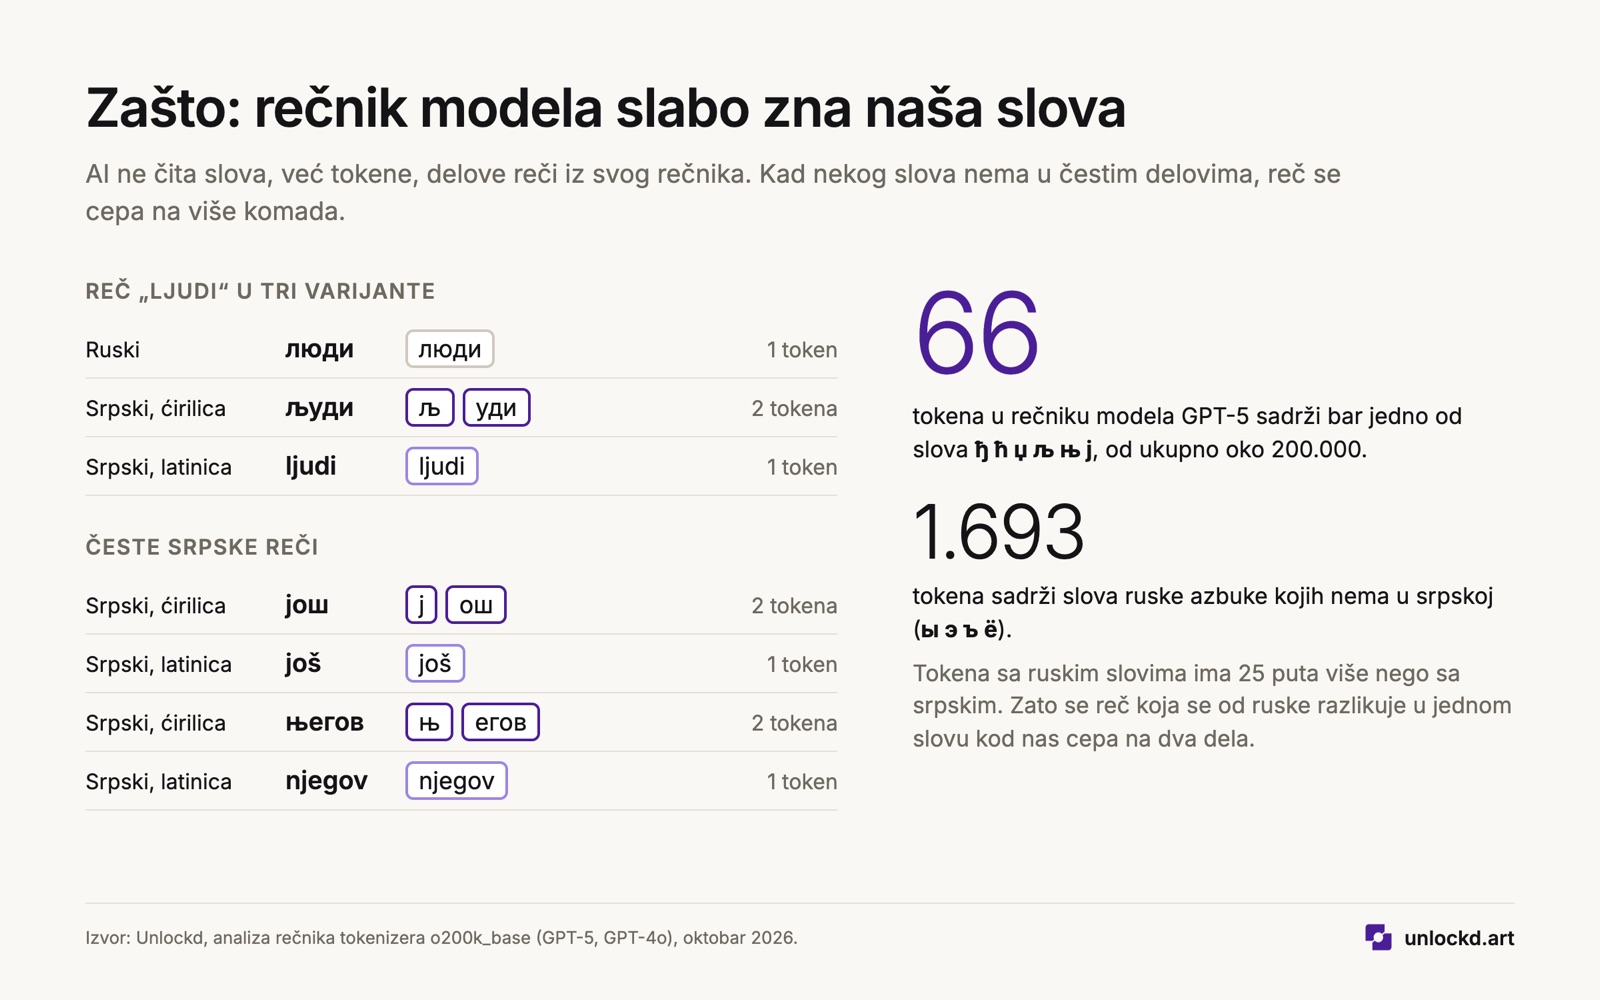
Pogledali smo rečnik koji koristi GPT-5. Od oko 200.000 tokena, više od 14.000 sadrži ćirilična slova. Samo 66 sadrži bar jedno od slova ђ, ћ, џ, љ, њ ili ј, koja postoje u srpskom, a nema ih u ruskom. Slova ruske azbuke kojih nema u srpskoj (ы, э, ъ i ё) nalaze se u 1.693 tokena, više od 25 puta češće. Slična slika je i kod drugih modela: tokena sa srpskim slovima ima između 12 i 170, a sa ruskim između 193 i 2.324.
Posledica se vidi na običnim rečima. Ruska reč „люди“ je jedan token. Srpska reč „људи“, koja se razlikuje u jednom slovu, model seče na dva dela: „љ“ i „уди“. Isto se dešava sa rečima „још“ i „његов“. Na latinici su „ljudi“, „još“ i „njegov“ jedan token, jer se ta slova u latinici pišu kombinacijama koje model dobro poznaje.
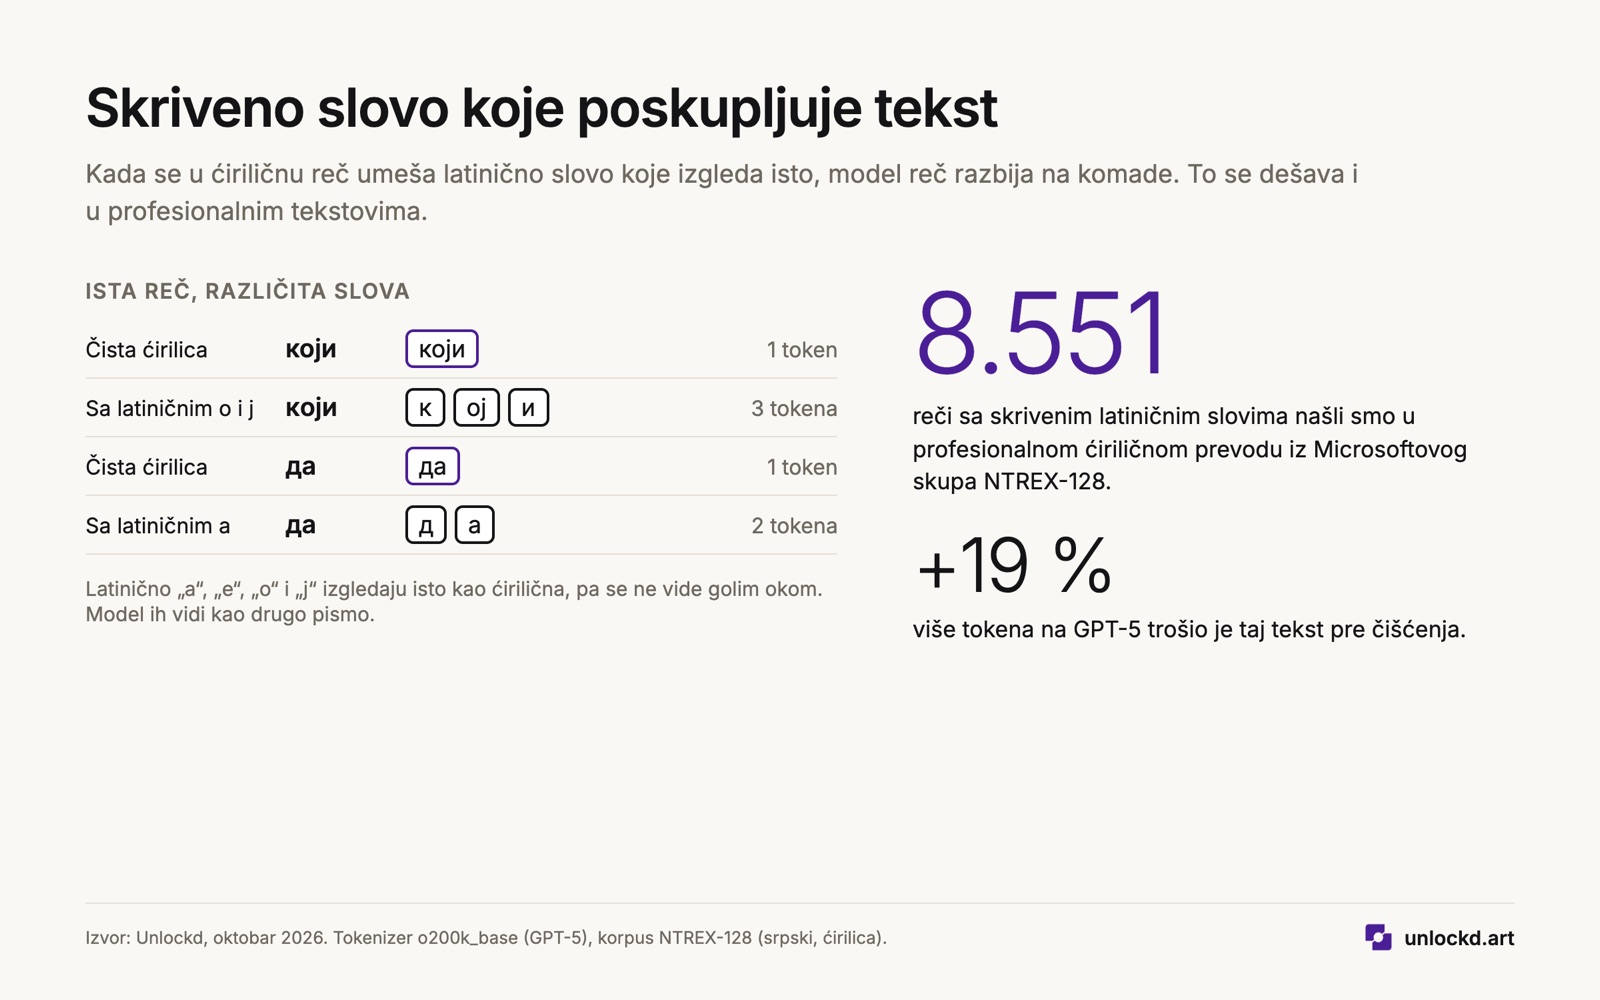
Skriveno slovo koje poskupljuje tekst
Tokom merenja naišli smo na problem koji se ne vidi golim okom. U profesionalnom ćiriličnom prevodu iz Microsoftovog skupa našli smo 8.551 reč u koju je umešano latinično slovo: „a“, „e“, „o“ ili „j“. Ta slova izgledaju isto kao ćirilična, ali za model su drugo pismo. Reč „који“ napisana čistom ćirilicom je jedan token. Kada su „o“ i „j“ u njoj latinični, ista reč postaje tri tokena. Zbog takvih slova taj tekst je na GPT-5 trošio 19 odsto više tokena nego posle čišćenja. Ovakvih reči ima i u vestima RTS, ali mnogo manje: pedesetak u celom uzorku.
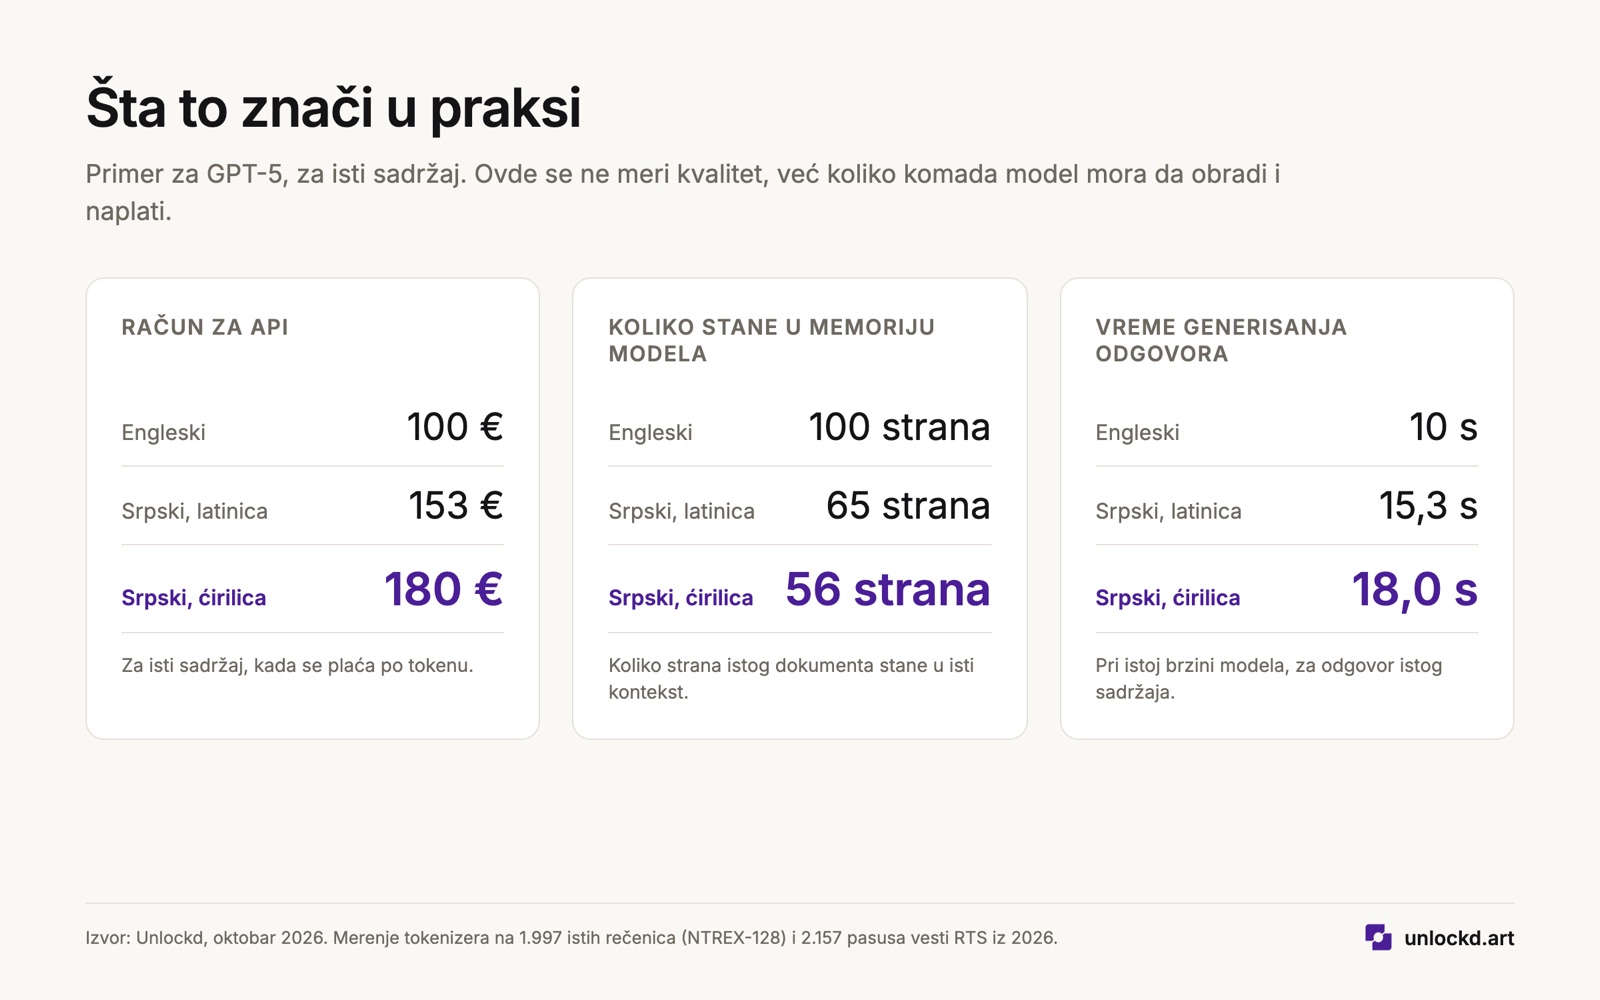
Šta to znači u novcu i vremenu
Za korisnika koji ponekad postavi pitanje četbotu, ova razlika se ne oseti. Za firmu koja preko API veze obrađuje desetine hiljada poruka dnevno, oseti se na kraju meseca. Ako na engleskom za neki posao na GPT-5 plati 100 evra, za isti sadržaj na srpskoj latinici plaća oko 153, a na ćirilici oko 180 evra.
Isto važi za memoriju modela. U prostor u koji stane dokument od 100 strana na engleskom, isti dokument na srpskoj latinici stane do 65. strane, a na ćirilici do 56. Kod dugih ugovora, pravilnika ili tehničke dokumentacije to znači da model ranije „zaboravi“ početak.
Pošto model piše odgovor token po token, duži zapis znači i sporiji odgovor. Pri istoj brzini, odgovor koji na engleskom stigne za deset sekundi na latinici traje oko 15, a na ćirilici oko 18 sekundi.
Niko ovo nije uradio namerno. Tokenizeri se prave na tekstovima kojih ima najviše, a srpskog, posebno na ćirilici, u tim podacima očigledno ima malo. Posledica je ipak ista kao da je uveden porez: ko piše na srpskom plaća više, a ko piše ćirilicom plaća još više.
Programeri i četbotovi
Isto smo izmerili i na kodu. Jednostavna JavaScript funkcija sa imenima promenljivih i komentarima na engleskom ima 142 tokena na GPT-5. Ista funkcija sa imenima i komentarima na srpskom ima 205, odnosno 44 odsto više.
Poseban trošak su uputstva koja se modelu šalju uz svaki zahtev, takozvani sistemski prompt. Kratko uputstvo za četbot korisničke podrške na engleskom ima 88 tokena, na srpskoj latinici 123, a na ćirilici 143. Ta razlika se plaća pri svakoj poruci svakog korisnika.
Dva mita
Prvi mit je da „šišana“ latinica, bez kvačica, štedi tokene. Na GPT-5 i Googleovom tokenizeru ušteda ne postoji, tekst bez kvačica je čak neznatno skuplji. Kod ostalih modela ušteda je najviše četiri odsto.
Drugi mit je da je neki od jezika u regionu „pametniji“ za AI. Srpska latinica, hrvatski, bosanski i slovenački na GPT-5 koštaju gotovo isto: između 1,49 i 1,53 tokena na svaki token engleskog. Razlika se pojavljuje tek kada se promeni pismo.
Domaći modeli ne rešavaju problem
Srpski modeli objavljeni 2026. na platformi Hugging Face koje smo proverili nastali su doučavanjem kineskog modela Qwen. Zadržali su njegov tokenizer, pa na istom tekstu troše isto tokena kao original. Model može da nauči da bolje piše na srpskom, ali ako se rečnik ne promeni, račun ostaje isti.
Šta firme mogu da urade odmah
- Očistiti tekstove od skrivenih latiničnih slova pre nego što se pošalju modelu. To je jednostavna provera koju program uradi za delić sekunde, a kod nekih tekstova smanjuje trošak i za petinu.
- Tražiti odgovor na latinici, a prikazati ga na ćirilici. Firma koja korisnicima mora da odgovara na ćirilici može da traži od modela odgovor na latinici, a da ga program pre prikaza preslovi. Na GPT-5 to smanjuje broj tokena u odgovoru za oko 15 odsto. Preslovljavanje sa latinice na ćirilicu je gotovo potpuno mehaničko. Izuzeci su retki, kao „injekcija“ ili „nadživeti“, gde „nj“ i „dž“ nisu jedno slovo, i strana imena, a rešavaju se kratkim spiskom izuzetaka.
- Izmeriti modele na sopstvenim tekstovima. Na engleskom se model koji troši najmanje i model koji troši najviše tokena, od osam koje smo merili, razlikuju za četiri odsto. Na srpskoj latinici ta razlika je 22, a na ćirilici 36 odsto.
Pre nego što se izabere model za domaći proizvod, vredi izmeriti koliko tokena troši baš na tekstovima te firme. Razlika između modela na srpskom je mnogo veća nego na engleskom, i ta razlika se plaća svaki dan. Ako pravite AI proizvod ili automatizaciju na srpskom, ovo merenje radimo pre izbora modela.
Ograničenja istraživanja
Merili smo broj tokena, a ne kvalitet odgovora. Da li modeli na ćirilici i češće greše, tema je za sledeće istraživanje. Claude kompanije Anthropic nije uključen jer njegov tokenizer nije javan. Za Gemini smo koristili tokenizer modela Gemma 4, za koji Google navodi da je isti kao kod Gemini modela. Iznosi u evrima su ilustracija odnosa, a ne cenovnik: stvarni račun zavisi od modela, cene i odnosa ulaznih i izlaznih tokena. Poređenje sa drugim jezicima zavisi i od prevoda, dok poređenje latinice i ćirilice taj problem nema, jer je tekst isti. Crnogorski nije posebno meren.
Kompletni podaci, kod za merenje i grafikoni dostupni su na zahtev, kako bi svako mogao da ponovi merenje. Pišite nam.
Izvori
- Gemma Team, Google DeepMind (jun 2026), Gemma 4 Technical Report
- Ovcharov (maj 2026), The Tokenizer Tax Across 25 European Languages
- Dobrovolskyi (jul 2026), Beyond Two Bytes per Letter: Tokenization Overhead in Cyrillic AI Systems
- Vesti RTS, april do oktobar 2026.
- Microsoft, NTREX-128, skup profesionalnih prevoda
Česta pitanja
Zašto AI naplaćuje srpski više od engleskog?
Jezički modeli ne naplaćuju po reči, nego po tokenu, komadu teksta iz rečnika modela. Rečnik se pravi na tekstovima kojih ima najviše, a srpskog u njima ima malo. Zato se srpske reči češće seku na više komada, pa isti sadržaj troši više tokena: na GPT-5 oko 53% više na latinici i 80% više na ćirilici nego na engleskom.
Da li je ćirilica skuplja od latinice u svim modelima?
Da. U svih osam modela koje smo merili isti tekst na ćirilici troši više tokena nego na latinici: Kimi K3 24% više, GPT-5 17%, Gemini 15%, Qwen3.8 i GLM-5.3 14%, Mistral 7%, Llama 4 i DeepSeek 5%. Na GPT-5 je ćirilični pasus skuplji od latiničnog u 99% slučajeva.
Da li tekst bez kvačica štedi tokene?
Ne. Na GPT-5 i Googleovom tokenizeru tekst bez kvačica nije jeftiniji, čak je neznatno skuplji. Kod ostalih modela ušteda je najviše 4%.
Kako firma može da smanji trošak AI-ja na srpskom?
Tri stvari: očistiti tekst od latiničnih slova umešanih u ćirilicu pre slanja modelu, tražiti od modela odgovor na latinici i program ga pre prikaza presloviti u ćirilicu (oko 15% manje tokena na GPT-5), i pre izbora modela izmeriti koliko tokena troši baš na tekstovima te firme, jer je razlika između modela na srpskom do 36%, a na engleskom 4%.