
Los modelos de IA cobran por token, y el inglés es el idioma más barato que existe. El mismo trabajo cuesta un 50 a 129% más en otro idioma. Aquí está el porqué.
Toda empresa que pone precio a una función de IA hace lo mismo: leer el precio por millón de tokens, lanzar una demo rápida en inglés y multiplicar. La demo está en inglés porque así se presentan estas herramientas. La factura no está en inglés. Está en su idioma, y su idioma casi con seguridad cuesta más.
Los modelos cobran por token, y el inglés es el suelo
Un gran modelo de lenguaje no cobra por palabra, sino por token: un trozo de texto del vocabulario fijo del modelo, a veces una palabra entera, a veces una sílaba, a veces una sola letra. Cuantos más trozos, mayor la factura, más lenta la respuesta y menos texto mantiene el modelo en memoria a la vez.
Ese vocabulario se construye con los datos de entrenamiento, abrumadoramente en inglés. Las palabras inglesas sobreviven más a menudo como un solo token. Los idiomas más raros se cortan en más trozos pequeños. El mismo significado, en otro idioma, cuesta en silencio más en cada llamada.
Lo medimos, y la brecha es grande
Pasamos el mismo texto por los tokenizadores de ocho modelos actuales, entre ellos GPT-5, Gemini, Llama 4, Mistral, DeepSeek, Qwen, Kimi y GLM. En resumen:
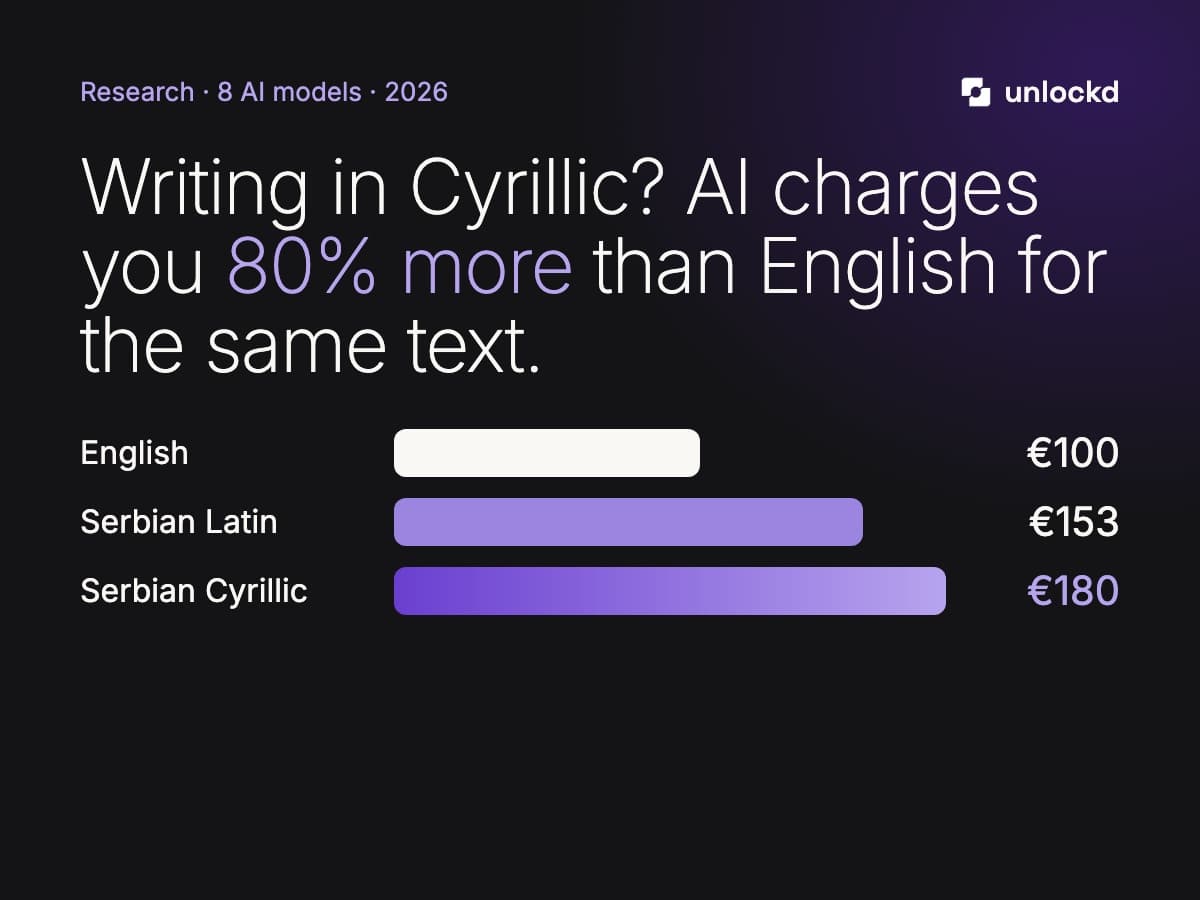
- Un contenido que cuesta 100 tokens en inglés cuesta unos 153 en serbio latino y 180 en serbio cirílico en GPT-5.
- En los ocho modelos, el alfabeto latino cuesta un 50 a 84% más que el inglés, y el cirílico un 65 a 129% más.
- Los alfabetos no latinos pagan más, y la penalización aparece en todos los modelos, no en uno solo.
El serbio es un idioma. El mecanismo es universal: todo idioma raro en los datos de entrenamiento se divide en más tokens, y los alfabetos no latinos suelen pagar la versión más pronunciada.
Por qué va más allá de la factura
Más tokens significan respuestas más lentas, porque el modelo genera token a token. Significan menos espacio en la ventana de contexto, así que los documentos largos se cortan antes que los mismos en inglés. Y significan que el modelo más barato en inglés a menudo no es el más barato en su idioma: la diferencia entre modelos llega al 36% en serbio y solo al 4% en inglés.
Cómo medirlo antes de comprometerse
- Mida con su propio texto. Tome contenido real en su idioma y cuente los tokens en exactamente los modelos que considera. El benchmark en inglés del proveedor no coincidirá.
- Compare modelos, no solo precios. Como la diferencia entre modelos crece fuera del inglés, el modelo correcto para un producto en inglés suele ser el equivocado para el suyo.
- Diseñe en torno al coste. Mantenga los prompts de sistema en inglés donde el usuario no los ve, y limpie los alfabetos mezclados antes de enviar.
Eso es justo lo que integramos en la automatización de IA a medida: la automatización se diseña en torno a lo que cuesta de verdad funcionar en su idioma, no en torno a una demo en inglés. Si planea una función de IA y quiere saber su coste real en su mercado, reserve una llamada estratégica técnica y lo mediremos juntos.
Preguntas frecuentes
¿Por qué la IA cuesta más en algunos idiomas que en inglés?
Los modelos cobran por token, un trozo de texto del vocabulario del modelo. Ese vocabulario se construye con los textos más vistos, abrumadoramente en inglés. Los idiomas más raros se cortan en más trozos, así que el mismo contenido usa más tokens y cuesta más. Medimos el serbio en un 50 a 84% más que el inglés en alfabeto latino y hasta un 129% más en cirílico.
¿Cómo reduzco el coste de la IA en mi idioma?
Mida los modelos candidatos con su propio texto antes de elegir, porque la diferencia entre modelos es mucho mayor en otros idiomas que en inglés. Mantenga los prompts de sistema y los pasos internos en inglés donde el usuario no los ve, y diseñe la automatización en torno al coste real en tokens y no en torno a una demo en inglés.
Servicios relacionados
Siga leyendo
 ¿Cuánto cuesta un software a medida para una pyme? · 5 min de lectura
 Sistema de reservas online propio o plataforma: cuándo compensa · 5 min de lectura
 Automatización con IA para empresas: por dónde empezar · 5 min de lectura