
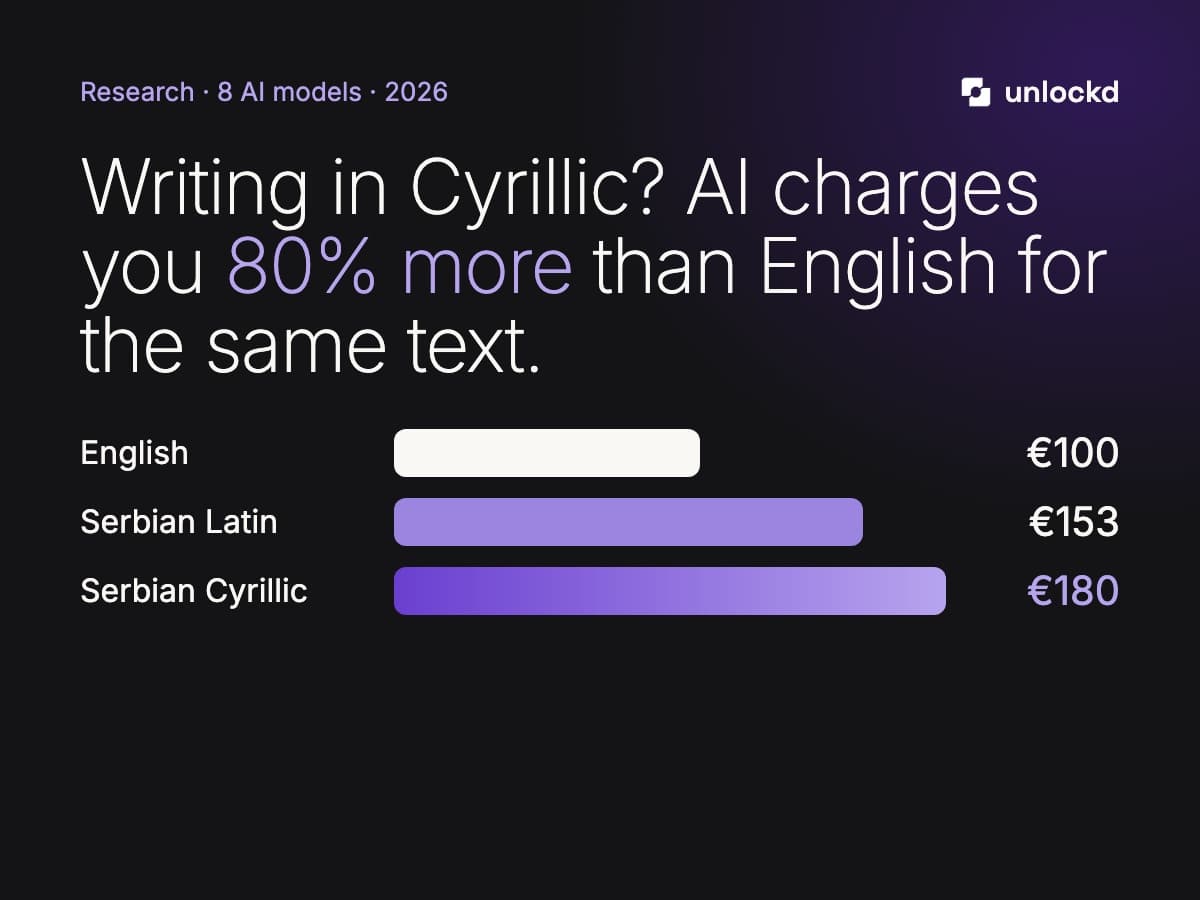
AI-modellen rekenen per token, en Engels is de goedkoopste taal die er is. Hetzelfde werk kost 50 tot 129% meer in een andere taal. Dit is waarom, en hoe u het meet.
Elk bedrijf dat een AI-functie prijst doet hetzelfde: de prijs per miljoen tokens lezen, een snelle demo in het Engels draaien, en vermenigvuldigen. De demo is in het Engels omdat deze tools zo worden gepresenteerd. De rekening is niet in het Engels. Die is in uw taal, en uw taal kost vrijwel zeker meer.
Modellen rekenen per token, en Engels is de bodem
Een groot taalmodel rekent niet per woord, maar per token: een stukje tekst uit de vaste woordenschat van het model, soms een heel woord, soms een lettergreep, soms één letter. Hoe meer stukjes, hoe hoger de rekening, hoe trager het antwoord en hoe minder tekst het model tegelijk in het geheugen houdt.
Die woordenschat is gebouwd op de trainingsdata, en die is overwegend Engels. Engelse woorden overleven vaker als één token. Zeldzamere talen worden in meer, kleinere stukjes gehakt. Dezelfde betekenis kost in een andere taal dus stil meer bij elke aanroep.
We hebben het gemeten, en het gat is groot
We lieten dezelfde tekst door de tokenizers van acht actuele modellen lopen, waaronder GPT-5, Gemini, Llama 4, Mistral, DeepSeek, Qwen, Kimi en GLM. Kort samengevat:
- Inhoud die 100 tokens kost in het Engels, kost ongeveer 153 tokens in Servisch Latijns schrift en 180 in Servisch Cyrillisch op GPT-5.
- Over alle acht modellen kost Latijns schrift 50 tot 84% meer dan Engels, en Cyrillisch 65 tot 129% meer.
- Niet-Latijnse schriften betalen het meest, en de boete verschijnt in elk model, niet in één.
Servisch is één taal. Het mechanisme is universeel: elke taal die zeldzaam was in de trainingsdata wordt in meer tokens opgedeeld, en niet-Latijnse schriften betalen doorgaans de steilste versie.
Waarom het verder reikt dan de rekening
Meer tokens betekent tragere antwoorden, want het model genereert token voor token. Het betekent minder ruimte in het contextvenster, dus lange documenten worden eerder afgekapt dan dezelfde documenten in het Engels. En het betekent dat het goedkoopste model in het Engels vaak niet het goedkoopste is in uw taal: het verschil tussen modellen loopt op tot 36% in het Servisch en slechts 4% in het Engels.
Hoe u het meet voordat u zich vastlegt
- Meet op uw eigen tekst. Neem echte inhoud in uw taal en tel de tokens op precies de modellen die u overweegt. De Engelse benchmark van de aanbieder klopt niet.
- Vergelijk modellen, niet alleen prijzen. Omdat het verschil tussen modellen groter wordt buiten het Engels, is het juiste model voor een Engels product vaak het verkeerde voor dat van u.
- Ontwerp rond de kosten. Houd systeemprompts in het Engels waar de gebruiker ze niet ziet, en maak schrift schoon vóór verzending.
Precies dat bouwen we in bij AI-automatisering op maat: de automatisering is ontworpen rond wat het werkelijk kost om in uw taal te draaien, niet rond een Engelse demo. Plant u een AI-functie en wilt u weten wat die echt kost in uw markt, boek dan een technisch strategiegesprek en we meten het samen.
Veelgestelde vragen
Waarom is AI duurder in sommige talen dan in het Engels?
Modellen rekenen per token, een stukje tekst uit de woordenschat van het model. Die woordenschat is gebouwd op de tekst die het model het vaakst zag: overwegend Engels. Zeldzamere talen worden in meer, kleinere stukjes gehakt, dus dezelfde inhoud gebruikt meer tokens en kost meer. We maten Servisch op 50 tot 84% meer dan Engels in Latijns schrift en tot 129% meer in Cyrillisch.
Hoe verlaag ik de AI-kosten in mijn taal?
Meet kandidaat-modellen op uw eigen tekst voordat u kiest, want het verschil tussen modellen is in andere talen veel groter dan in het Engels. Houd systeemprompts en interne stappen in het Engels waar de gebruiker ze niet ziet, en ontwerp de automatisering rond de werkelijke tokenkosten in plaats van rond een Engelse demo.