
KI-Modelle rechnen pro Token ab, und Englisch ist die günstigste Sprache überhaupt. Dieselbe Arbeit kostet in einer anderen Sprache 50 bis 129% mehr. Hier ist der Grund.
Jedes Unternehmen, das ein KI-Feature kalkuliert, macht dasselbe: den Preis pro Million Tokens lesen, eine schnelle Demo auf Englisch laufen lassen und multiplizieren. Die Demo ist auf Englisch, weil diese Werkzeuge so präsentiert werden. Die Rechnung ist nicht auf Englisch. Sie ist in Ihrer Sprache, und Ihre Sprache kostet fast sicher mehr.
Modelle rechnen pro Token ab, und Englisch ist der Boden
Ein großes Sprachmodell rechnet nicht pro Wort, sondern pro Token: ein Textstück aus dem festen Vokabular des Modells, mal ein ganzes Wort, mal eine Silbe, mal ein einzelner Buchstabe. Je mehr Stücke, desto höher die Rechnung, desto langsamer die Antwort und desto weniger Text hält das Modell gleichzeitig im Speicher.
Dieses Vokabular ist aus den Trainingsdaten gebaut, und die sind überwiegend englisch. Englische Wörter überleben häufiger als ein Token. Seltenere Sprachen werden in mehr, kleinere Stücke zerschnitten. Dieselbe Bedeutung kostet in einer anderen Sprache also still mehr bei jedem Aufruf.
Wir haben es gemessen, und der Abstand ist groß
Wir ließen denselben Text durch die Tokenizer von acht aktuellen Modellen laufen, darunter GPT-5, Gemini, Llama 4, Mistral, DeepSeek, Qwen, Kimi und GLM. Kurz:
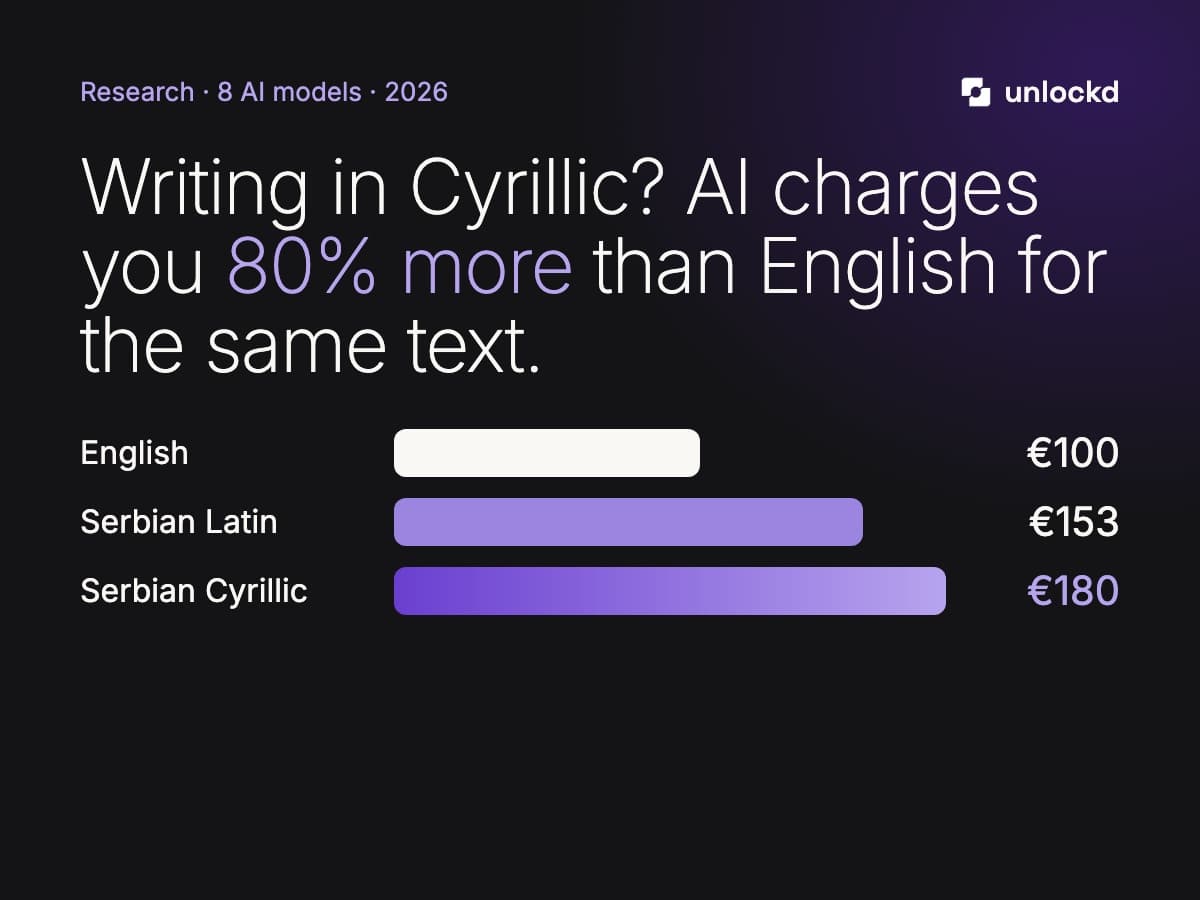
- Inhalt, der auf Englisch 100 Tokens kostet, kostet auf GPT-5 etwa 153 Tokens in serbischer lateinischer Schrift und 180 in serbischer kyrillischer.
- Über alle acht Modelle kostet lateinische Schrift 50 bis 84% mehr als Englisch, kyrillische 65 bis 129% mehr.
- Nicht-lateinische Schriften zahlen am meisten, und der Aufschlag erscheint in jedem Modell, nicht nur in einem.
Serbisch ist eine Sprache. Der Mechanismus ist universell: Jede Sprache, die in den Trainingsdaten selten war, wird in mehr Tokens zerlegt, und nicht-lateinische Schriften zahlen in der Regel die steilste Version.
Warum es über die Rechnung hinausgeht
Mehr Tokens bedeuten langsamere Antworten, denn das Modell erzeugt Token für Token. Es bedeutet weniger Platz im Kontextfenster, sodass lange Dokumente früher abgeschnitten werden als dieselben auf Englisch. Und es bedeutet, dass das günstigste Modell auf Englisch oft nicht das günstigste in Ihrer Sprache ist: Der Abstand zwischen Modellen erreicht 36% im Serbischen und nur 4% im Englischen.
So messen Sie es, bevor Sie sich festlegen
- Messen Sie an Ihrem eigenen Text. Nehmen Sie echte Inhalte in Ihrer Sprache und zählen Sie die Tokens an genau den Modellen, die Sie erwägen. Der englische Benchmark des Anbieters passt nicht.
- Vergleichen Sie Modelle, nicht nur Preise. Weil der Abstand zwischen Modellen außerhalb des Englischen wächst, ist das richtige Modell für ein englisches Produkt oft das falsche für Ihres.
- Gestalten Sie um die Kosten herum. Halten Sie System-Prompts auf Englisch, wo der Nutzer sie nicht sieht, und bereinigen Sie gemischte Schriften vor dem Senden.
Genau das bauen wir in die KI-Automatisierung nach Maß ein: Die Automatisierung ist um die realen Betriebskosten in Ihrer Sprache herum gestaltet, nicht um eine englische Demo. Planen Sie ein KI-Feature und wollen wissen, was es in Ihrem Markt wirklich kostet, buchen Sie ein technisches Strategiegespräch, und wir messen es gemeinsam.
Häufige Fragen
Warum kostet KI in manchen Sprachen mehr als auf Englisch?
Modelle rechnen pro Token ab, einem Textstück aus dem Vokabular des Modells. Dieses Vokabular ist aus den Texten gebaut, die das Modell am häufigsten sah: überwiegend Englisch. Seltenere Sprachen werden in mehr, kleinere Stücke zerschnitten, also braucht derselbe Inhalt mehr Tokens und kostet mehr. Wir maßen Serbisch mit 50 bis 84% mehr als Englisch in lateinischer Schrift und bis zu 129% mehr in kyrillischer.
Wie senke ich die KI-Kosten in meiner Sprache?
Messen Sie Kandidatenmodelle an Ihrem eigenen Text, bevor Sie wählen, denn der Abstand zwischen Modellen ist in anderen Sprachen weit größer als auf Englisch. Halten Sie System-Prompts und interne Schritte auf Englisch, wo der Nutzer sie nie sieht, und gestalten Sie die Automatisierung um die realen Tokenkosten statt um eine englische Demo.