
Les modèles d'IA facturent au token, et l'anglais est la langue la moins chère qui soit. Le même travail coûte 50 à 129% de plus dans une autre langue. Voici pourquoi.
Toute entreprise qui chiffre une fonctionnalité d'IA fait la même chose : lire le prix au million de tokens, lancer une démo rapide en anglais, puis multiplier. La démo est en anglais parce que ces outils sont présentés ainsi. La facture, elle, n'est pas en anglais. Elle est dans votre langue, et votre langue coûte presque certainement plus cher.
Les modèles facturent au token, et l'anglais est le plancher
Un grand modèle de langage ne facture pas au mot, mais au token : un morceau de texte issu du vocabulaire fixe du modèle, parfois un mot entier, parfois une syllabe, parfois une seule lettre. Plus il y a de morceaux, plus la facture est élevée, plus la réponse est lente, et moins le modèle garde de texte en mémoire à la fois.
Ce vocabulaire est bâti sur les données d'entraînement, massivement anglaises. Les mots anglais survivent plus souvent en un seul token. Les langues plus rares sont découpées en davantage de petits morceaux. La même intention coûte donc silencieusement plus cher à chaque appel.
Nous l'avons mesuré, et l'écart est grand
Nous avons passé le même texte dans les tokenizers de huit modèles actuels, dont GPT-5, Gemini, Llama 4, Mistral, DeepSeek, Qwen, Kimi et GLM. En bref :
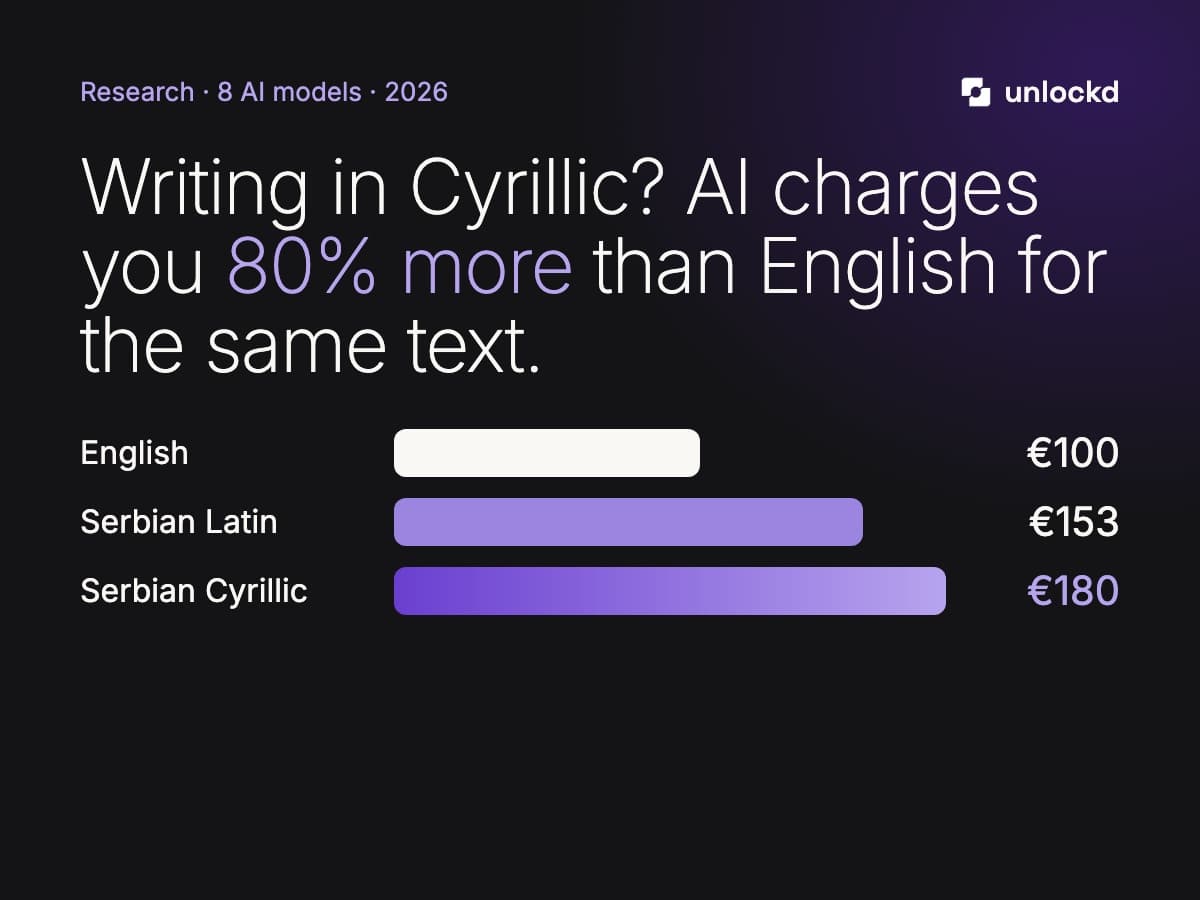
- Un contenu qui coûte 100 tokens en anglais en coûte environ 153 en serbe latin et 180 en serbe cyrillique sur GPT-5.
- Sur les huit modèles, l'écriture latine coûte 50 à 84% de plus que l'anglais, et le cyrillique 65 à 129% de plus.
- Les écritures non latines paient le plus, et la pénalité apparaît dans chaque modèle, pas dans un seul.
Le serbe n'est qu'une langue. Le mécanisme est universel : toute langue rare dans les données d'entraînement est découpée en plus de tokens, et les écritures non latines paient en général la version la plus forte.
Pourquoi cela dépasse la facture
Plus de tokens, c'est des réponses plus lentes, car le modèle génère token par token. C'est moins de place dans la fenêtre de contexte, donc les longs documents sont coupés plus tôt que les mêmes en anglais. Et c'est que le modèle le moins cher en anglais n'est souvent pas le moins cher dans votre langue : l'écart entre modèles atteint 36% en serbe et seulement 4% en anglais.
Comment le mesurer avant de vous engager
- Mesurez sur votre propre texte. Prenez du contenu réel dans votre langue et comptez les tokens sur exactement les modèles envisagés. Le benchmark anglais du fournisseur ne correspondra pas.
- Comparez les modèles, pas seulement les prix. Comme l'écart entre modèles grandit hors de l'anglais, le bon modèle pour un produit anglais est souvent le mauvais pour le vôtre.
- Concevez autour du coût. Gardez les prompts système en anglais là où l'utilisateur ne les voit pas, et nettoyez les écritures mélangées avant l'envoi.
C'est exactement ce que nous intégrons à l'automatisation IA sur mesure : l'automatisation est conçue autour de ce qu'elle coûte réellement dans votre langue, pas autour d'une démo anglaise. Si vous préparez une fonctionnalité d'IA et voulez savoir son coût réel sur votre marché, réservez un appel stratégique technique et nous le mesurerons ensemble.
Questions fréquentes
Pourquoi l'IA coûte-t-elle plus cher dans certaines langues qu'en anglais ?
Les modèles facturent au token, un morceau de texte issu du vocabulaire du modèle. Ce vocabulaire est bâti sur les textes les plus vus, massivement anglais. Les langues plus rares sont découpées en davantage de morceaux, donc le même contenu consomme plus de tokens et coûte plus. Nous avons mesuré le serbe à 50 à 84% de plus que l'anglais en écriture latine et jusqu'à 129% de plus en cyrillique.
Comment réduire le coût de l'IA dans ma langue ?
Mesurez les modèles candidats sur votre propre texte avant de choisir, car l'écart entre modèles est bien plus grand dans les autres langues qu'en anglais. Gardez les prompts système et les étapes internes en anglais là où l'utilisateur ne les voit pas, et concevez l'automatisation autour du coût réel en tokens plutôt qu'autour d'une démo anglaise.
Services associés
À lire ensuite
 Automatiser son entreprise avec l'IA : par où commencer, sans se tromper · 4 min de lecture
 Logiciel de prise de rendez-vous : plateforme ou système sur mesure ? · 5 min de lecture